 Retour au blog
Votre VPS ralentit à 02:00. Un service a redémarré, le journal compte des centaines de lignes et la cause n’est pas évidente. Un assistant IA peut transformer ces éléments en un bref plan de diagnostic en quelques secondes. Le pas dangereux consiste à supposer qu’il devrait aussi recevoir un accès root illimité et réparer seul la production.
Le modèle utile est une administration assistée par l’IA et approuvée par un humain. La surveillance détecte le problème, l’IA aide à interpréter les éléments et une personne responsable décide des changements. Cette distinction permet de tirer parti de l’IA sans transformer une réponse plausible mais fausse en indisponibilité.
Là où l’IA est réellement utile
L’IA fonctionne mieux lorsque la tâche repose sur des éléments clairs, un périmètre limité et un résultat vérifiable. Elle peut accélérer l’analyse courante et aider les administrateurs à comprendre un système inconnu.
- Résumer une courte période des journaux d’un service et établir la chronologie d’un incident.
- Expliquer une commande, une directive de configuration ou un message d’erreur avant d’agir.
- Comparer une configuration fonctionnelle et une configuration défaillante pour relever les différences importantes.
- Mettre en relation les contraintes CPU, mémoire, disque et réseau avec les symptômes de l’application.
- Préparer un script, une unité systemd ou une modification Ansible pour examen.
- Rédiger un plan de retour arrière et une liste de vérification.
Elle convient beaucoup moins comme autorité finale pour des opérations destructrices ou ambiguës. Les changements de disque, le remplacement du pare-feu, les modifications d’authentification, les migrations de base de données, les suppressions de paquets et les restaurations peuvent entraîner des interruptions ou des pertes de données, même si la commande générée est syntaxiquement correcte.
Choisissez le bon niveau d’accès pour l’IA
Trois modes pratiques sont possibles. Commencez avec le moins d’accès possible et passez à un modèle plus autonome uniquement lorsque le bénéfice justifie le risque supplémentaire.
Conseiller. Donnez à l’IA une courte sortie de commande ou un extrait de journal expurgé des données sensibles. Vous exécutez vous-même chaque commande. C’est le point de départ le plus sûr, souvent suffisant pour un dépannage occasionnel.
Copilote. Exécutez un outil IA en terminal sur votre poste d’administration. Il peut examiner un dépôt local de configuration et préparer des commandes SSH ou des modifications de fichiers, que vous approuvez avant leur application au VPS.
Agent restreint. Laissez l’outil se connecter avec son propre compte serveur non privilégié. Cela permet des diagnostics reproductibles, mais sa clé SSH, ses accès aux fichiers, ses groupes et sa portée réseau doivent être définis aussi soigneusement que pour un opérateur humain.
Le compte serveur constitue la véritable frontière de sécurité, pas la promesse du modèle d’être prudent. N’ajoutez pas l’agent aux groupes sudo, docker ou à un autre groupe conférant de fait un accès root sans raison précisément définie et auditée.
Mettre en place un processus IA sûr
Installez l’assistant hors de la production
Pour la plupart des équipes, la solution la plus claire consiste à installer l’assistant en terminal sur un poste d’administration ou un hôte de gestion contrôlé, plutôt que directement en root sur le VPS de production. Codex CLI et Claude Code sont deux exemples actuels ; vérifiez tout programme d’installation dans la documentation actuelle de son éditeur avant de l’exécuter.
Codex CLI : documentation d’installation
curl -fsSL https://chatgpt.com/codex/install.sh | sh
codex
Claude Code : documentation de configuration
curl -fsSL https://claude.ai/install.sh | bash
claude
N’exécutez aucun de ces programmes d’installation en root. Examinez les règles de validation des logiciels et de traitement des données de votre organisation, puis commencez par une consigne interdisant explicitement les modifications :
Il s’agit d’un VPS de production. Commence en lecture seule.
N’utilise pas sudo, ne modifie pas les fichiers, n’installe pas de paquets,
ne redémarre pas les services, ne modifie pas le pare-feu et ne révèle aucun secret.

Présente d’abord les commandes que tu prévois d’exécuter.
Explique ce que vérifie chaque commande et identifie toutes
les actions qui nécessiteraient une approbation humaine.
Donnez à l’agent une identité Linux distincte
Si l’assistant doit se connecter en SSH, créez un compte et une clé dédiés. L’exemple Debian ou Ubuntu suivant crée un compte sans connexion par mot de passe et autorise la lecture du journal sans sudo :
sudo adduser --disabled-password --gecos "" aiops
sudo install -d -m 700 -o aiops -g aiops \
  /home/aiops/.ssh
sudoedit /home/aiops/.ssh/authorized_keys
sudo chown aiops:aiops \
  /home/aiops/.ssh/authorized_keys
sudo chmod 600 /home/aiops/.ssh/authorized_keys
sudo usermod -aG systemd-journal aiops
Collez uniquement la clé publique dédiée dans authorized_keys et conservez la clé privée sur le poste de gestion approuvé. Les journaux peuvent contenir des URL, des jetons, des e-mails ou des données clients ; n’accordez cet accès que lorsqu’il est nécessaire.
Avant d’utiliser un nouveau compte en production, suivez le guide EDIS Global de renforcement de la sécurité SSH et testez la nouvelle connexion dans un deuxième terminal avant de fermer votre session d’administration existante.
La surveillance détecte ; l’IA interprète
L’IA ne devrait pas être le composant qui décide si le serveur fonctionne. La surveillance classique est déterministe, reproductible et peut alerter lorsque le VPS lui-même est inaccessible. Exécutez au moins un contrôle de disponibilité à l’extérieur du serveur.
Une solution pratique peut associer systemd et journald pour l’état des services, un moniteur HTTP ou TCP externe pour la disponibilité, Netdata pour une vue rapide d’un serveur, ou Prometheus Node Exporter et Grafana pour les mesures à long terme. Git et Ansible rendent les modifications vérifiables ; un outil de sauvegarde hors serveur permet la récupération.
Prometheus publie un guide de surveillance Node Exporter pour recueillir les mesures de l’hôte.
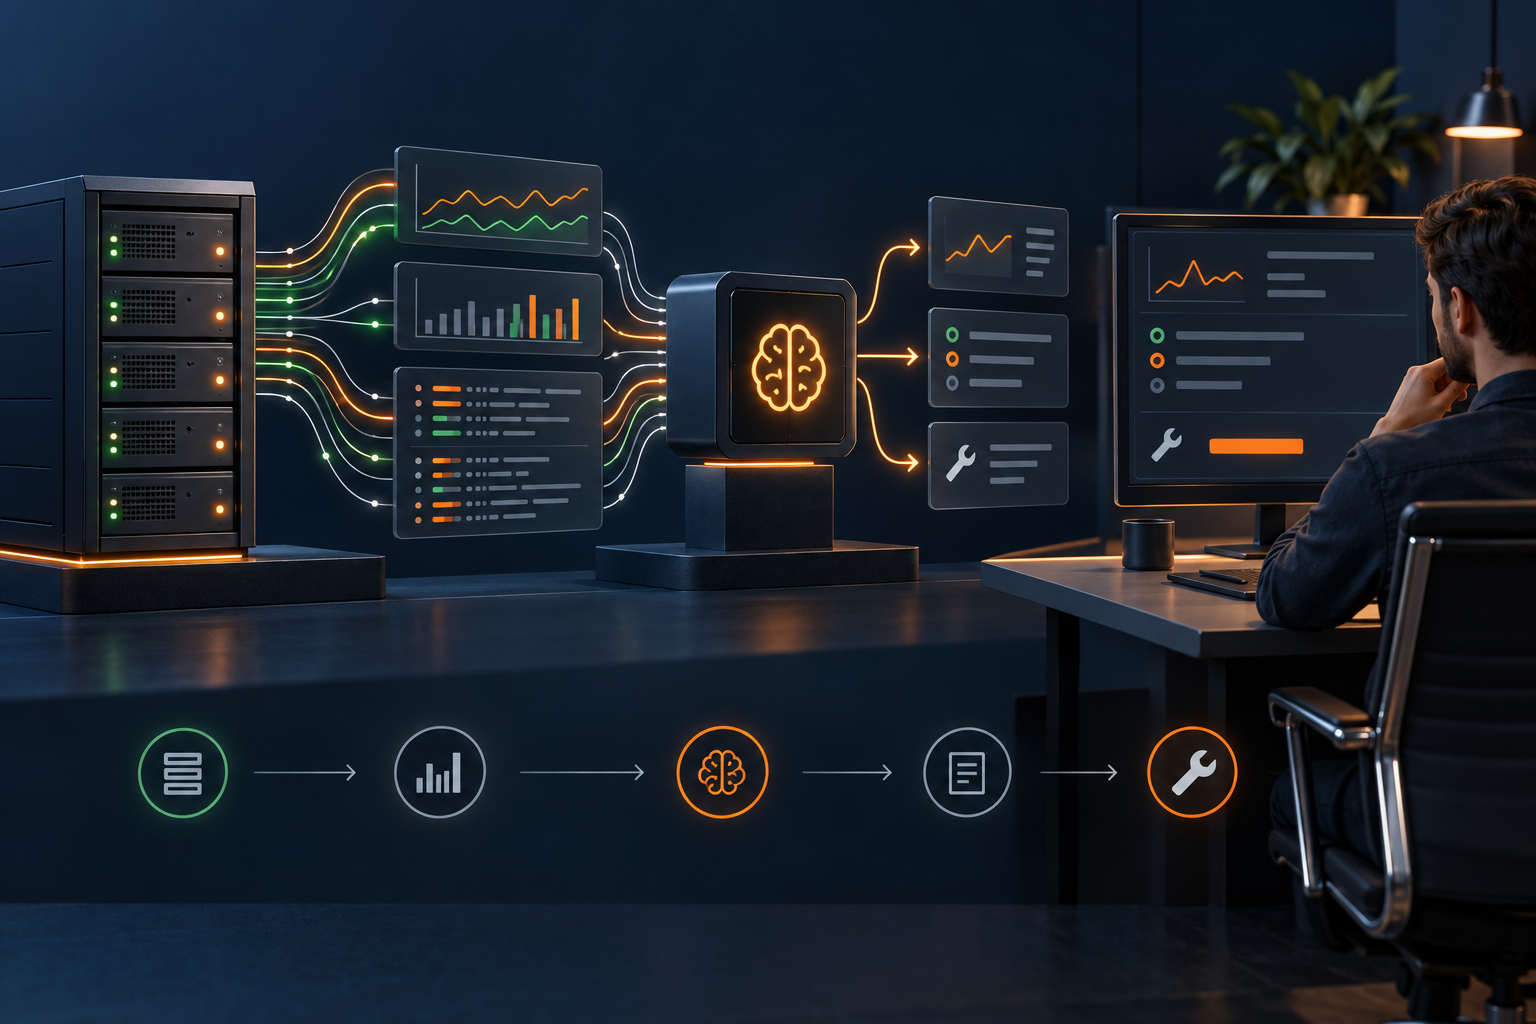
La surveillance recueille les signaux ; l’IA aide à les interpréter ; un humain approuve l’action suivante.
Recueillir un bref état de santé
Lorsqu’une alerte arrive, recueillez un ensemble limité de faits en lecture seule plutôt que de donner à un outil IA un accès illimité à tout le serveur :
date --iso-8601=seconds
uptime
free -h
df -hT -x tmpfs -x devtmpfs
systemctl --failed --no-pager
ss -s
journalctl -p warning..alert \
  --since '-60 minutes' --no-pager
Examinez la sortie avant de l’envoyer à un service IA externe. Retirez les identifiants, les en-têtes d’autorisation, les identifiants de session, les données clients et tout élément sans rapport avec l’incident. Le masquage automatique est utile, mais peut manquer des secrets.
Analyser les journaux sans s’y perdre
Une bonne investigation commence par le service touché et la période de l’incident. Pour Nginx, par exemple :
systemctl status nginx --no-pager
journalctl -u nginx --since '-30 minutes' --no-pager
journalctl -p err..alert --since '-2 hours' --no-pager
Ajoutez ensuite le contexte : système d’exploitation, symptôme exact, heure de début, dernier changement connu et éléments joints. Demandez à l’assistant de distinguer les faits des hypothèses et de solliciter d’autres éléments avant de recommander un redémarrage.
Système : Ubuntu 24.04
Service : proxy inverse Nginx
Application : gérée par systemd
Symptôme : réponses HTTP 502 depuis 14:20 UTC
Dernier changement : application déployée à 14:05 UTC

Établis une chronologie horodatée de l’incident.
Classe les causes probables et cite les éléments qui les étayent.
Identifie les éléments manquants et les prochaines étapes en lecture seule.
Pour les changements ultérieurs, précise l’impact, le retour arrière et la vérification.
Examinez chaque modification proposée par l’IA
Pour tout changement de production proposé, exigez la commande ou le diff exact, le résultat attendu, les effets secondaires possibles, un retour arrière et un test de vérification. Une configuration stockée dans Git peut être inspectée avant son application :
git status --short
git diff --check
git diff
Un playbook Ansible peut être vérifié avec ansible-playbook --check --diff, même si ce mode ne peut pas prévoir parfaitement les effets de chaque module ou application. Les changements risqués doivent toujours être testés sur un VPS de préproduction comparable à la production.
Appliquer la même méthode à Windows
L’administration assistée par IA ne se limite pas à Linux. PowerShell peut produire un état ciblé d’un VPS Windows, qu’un administrateur examine avant de le partager :
Get-ComputerInfo |
  Select-Object WindowsProductName, WindowsVersion,
    OsLastBootUpTime

Get-Volume |
  Select-Object DriveLetter, FileSystemLabel,
    SizeRemaining, Size

Get-Service |
  Where-Object Status -eq 'Stopped'

$since = (Get-Date).AddHours(-1)
Get-WinEvent -FilterHashtable @{
  LogName='System'
  Level=1,2,3
  StartTime=$since
} |
  Select-Object -First 100 TimeCreated, Id,
    ProviderName, LevelDisplayName, Message
Utilisez un compte Windows dédié avec les seules autorisations nécessaires au diagnostic. Ne donnez pas à un agent IA des identifiants d’administrateur de domaine, un accès illimité aux secrets de production ou l’autorité de redémarrer automatiquement un serveur critique.
Intégrez la récupération au plan
Une modification générée par IA peut sembler raisonnable et être inadaptée à votre application. Avant d’autoriser un accès direct, gardez des sauvegardes hors du VPS, testez une restauration réelle, consignez la configuration actuelle du pare-feu et du réseau et documentez l’accès d’urgence par le portail de gestion ou la console VNC.
Les clients VPS d’EDIS Global restent responsables de leurs données et de leur récupération. Consultez les consignes de sauvegarde actuelles avant d’introduire un agent IA dans un service important.
Une routine d’exploitation pratique
- Laissez la surveillance détecter et horodater le problème.
- Recueillez uniquement l’état du service touché, les mesures et la période de journal concernée.
- Retirez les secrets et les données clients sans rapport.
- Demandez à l’IA de distinguer faits, hypothèses et éléments manquants.
- Exécutez d’abord des commandes de diagnostic en lecture seule.
- Exigez un diff proposé, une évaluation de l’impact, un retour arrière et une vérification.
- Faites approuver et appliquer le changement par un administrateur responsable.
- Vérifiez le service depuis l’extérieur du VPS et mettez à jour la procédure d’exploitation.
L’IA ne transforme pas un VPS en service infogéré
L’IA peut accélérer le dépannage et rendre une petite équipe plus efficace, mais elle n’assume pas la responsabilité opérationnelle. Avec un VPS non infogéré, vous gérez toujours le système, les applications, les accès, les mises à jour, la surveillance, les données et la récupération.
Les meilleurs résultats viennent d’un serveur déjà administrable : accès sécurisé, surveillance pertinente, configuration versionnée et sauvegardes testées. Commencez par une assistance en lecture seule, n’étendez les droits que pour un besoin démontré et conservez une approbation humaine pour les changements en production.
Gestion VPS assistée par IA : questions fréquentes
L’IA peut examiner certaines données du serveur, expliquer des commandes, analyser des journaux, préparer des changements de configuration et documenter la restauration. Elle doit assister un administrateur responsable plutôt que devenir l’unique opérateur d’un VPS de production.
Pas par défaut. Commencez avec des informations sélectionnées ou un compte dédié sans privilèges. Si un accès direct est nécessaire, utilisez une clé SSH distincte, des autorisations minimales, des journaux d’audit et une validation humaine des changements privilégiés. Évitez un accès sudo illimité sans mot de passe.
L’approche la plus sûre consiste à exécuter un outil IA en terminal sur le poste de l’administrateur, puis à se connecter au VPS par SSH avec un compte restreint dédié. L’agent peut recueillir des éléments en lecture seule et préparer les changements ; un compte administrateur distinct examine et applique les opérations privilégiées.
L’IA peut interpréter les alertes et rapprocher les métriques des journaux, mais la collecte des données et la détection des pannes doivent reposer sur une supervision classique. Utilisez des contrôles de disponibilité externes et des outils comme Netdata, Prometheus ou Grafana, puis l’IA pour aider au diagnostic.
Seulement après avoir limité et vérifié les données. Exportez la période pertinente la plus courte, retirez les identifiants, jetons, données clients et entrées sans rapport, puis vérifiez la politique de traitement des données du fournisseur IA avant d’envoyer des informations d’exploitation.
Non. L’IA peut aider à l’administration, mais le propriétaire du VPS reste responsable du système, des applications, des accès, des mises à jour, de la supervision, des sauvegardes et de la restauration.