 返回博客
你的 VPS 在 02:00 变慢。某项服务已重启,日志长达数百行,而原因并不明显。AI 助手可以在几秒钟内将这些证据整理成一份简短的诊断方案。危险之处在于,想当然地认为同一个助手也应该获得不受限制的 root 访问权限,并自行修复生产环境。
实用的模式是由 AI 辅助、人工批准的服务器管理。监控系统检测问题,AI 帮助解读证据,由负有责任的人员决定要进行哪些更改。这一区别既能发挥 AI 的价值,又能避免一个看似合理但实际错误的答案导致停机。
AI 真正有用的场景
当任务有明确的证据、有限的范围以及可验证的结果时,AI 的表现最佳。它可以节省日常分析所需的时间,并帮助管理员了解不熟悉的系统。
- 汇总特定短时间窗口内的服务日志,并构建事件时间线。
- 在采取行动前,解释命令、配置指令或错误消息。
- 比较正常配置与故障配置,并突出显示有意义的差异。
- 将 CPU、内存、磁盘和网络压力与应用程序症状关联起来。
- 准备脚本、systemd 单元或 Ansible 更改以供审核。
- 编写回滚方案和验证清单。
对于破坏性或存在歧义的工作,AI 远不适合作为最终决策者。磁盘更改、防火墙替换、身份验证更改、数据库迁移、软件包移除和恢复操作,即使生成的命令在语法上正确,也可能导致停机或数据丢失。
选择合适的 AI 访问级别
有三种实用的运行模式。应从最低访问权限开始,只有当收益足以抵消额外风险时,才转向功能更强的模式。
顾问模式。向 AI 提供一小段经过脱敏的命令输出或日志摘录。所有命令都由你亲自运行。这是最安全的起点,对于偶尔进行故障排查通常已经足够。
副驾驶模式。在管理员工作站上运行终端 AI 工具。它可以检查本地配置仓库,并准备 SSH 命令或文件更改,而你需要在这些操作应用到 VPS 之前进行批准。
受限代理模式。让工具使用其专属的非特权服务器账户进行连接。这可以支持可重复的诊断,但其 SSH 密钥、文件访问权限、所属组和网络访问范围必须像任何人工操作员的一样经过谨慎设计。
真正的安全边界是服务器账户,而不是模型承诺会谨慎行事。除非有范围明确且经过审计的理由,否则不要让代理成为 sudo、docker 或其他实际上会授予 root 访问权限的组的成员。
建立安全的 AI 工作流程
在生产环境之外安装助手
对于大多数团队,最清晰的设计是将终端助手安装在管理员工作站或受控管理宿主机上,而不是直接以 root 身份安装在生产 VPS 上。目前的两个示例是 Codex CLI 和 Claude Code;运行任何安装程序之前,请根据供应商的最新文档进行核实。
Codex CLI:安装文档
curl -fsSL https://chatgpt.com/codex/install.sh | sh
codex
Claude Code:设置文档
curl -fsSL https://claude.ai/install.sh | bash
claude
不要以 root 身份运行任一安装程序。请审查你所在组织的软件审批和数据处理要求,然后从一条明确禁止进行更改的指令开始:
This is a production VPS. Begin in read-only mode.
Do not use sudo, modify files, install packages,
restart services, change the firewall or expose secrets.

First show the commands you intend to run.
Explain what each command checks and identify every
action that would require human approval.
为代理提供独立的 Linux 身份
如果助手必须通过 SSH 连接,请创建专用账户和密钥。以下 Debian 或 Ubuntu 示例会创建一个禁用密码登录的账户,并允许其在不使用 sudo 的情况下读取日志:
sudo adduser --disabled-password --gecos "" aiops
sudo install -d -m 700 -o aiops -g aiops \
  /home/aiops/.ssh
sudoedit /home/aiops/.ssh/authorized_keys
sudo chown aiops:aiops \
  /home/aiops/.ssh/authorized_keys
sudo chmod 600 /home/aiops/.ssh/authorized_keys
sudo usermod -aG systemd-journal aiops
仅将专用公钥粘贴到 authorized_keys 中,并将其私钥保存在获准使用的管理工作站上。日志可能包含 URL、令牌、电子邮件地址或客户数据,因此只有在确有需要时才应授予日志访问权限。
在生产环境中使用新账户之前,请遵循 EDIS Global SSH 安全加固指南,并在关闭现有管理会话之前,先在第二个终端中测试新账户登录。
让监控系统负责检测,让 AI 负责解读
AI 不应成为判断服务器是否正常运行的组件。传统监控具有确定性和可重复性,并且能在 VPS 本身无法访问时发出警报。至少应在服务器外部运行一项可用性检查。
一套实用的技术栈可以结合使用 systemd 和 journald 来监控服务状态,使用外部 HTTP 或 TCP 监控器检查可用性,使用 Netdata 快速查看单台服务器,或使用 Prometheus Node Exporter 和 Grafana 获取长期指标。Git 和 Ansible 可使配置更改便于审核;服务器外部的备份工具则可提供恢复途径。
Prometheus 发布了用于收集宿主机指标的 Node Exporter 监控指南。
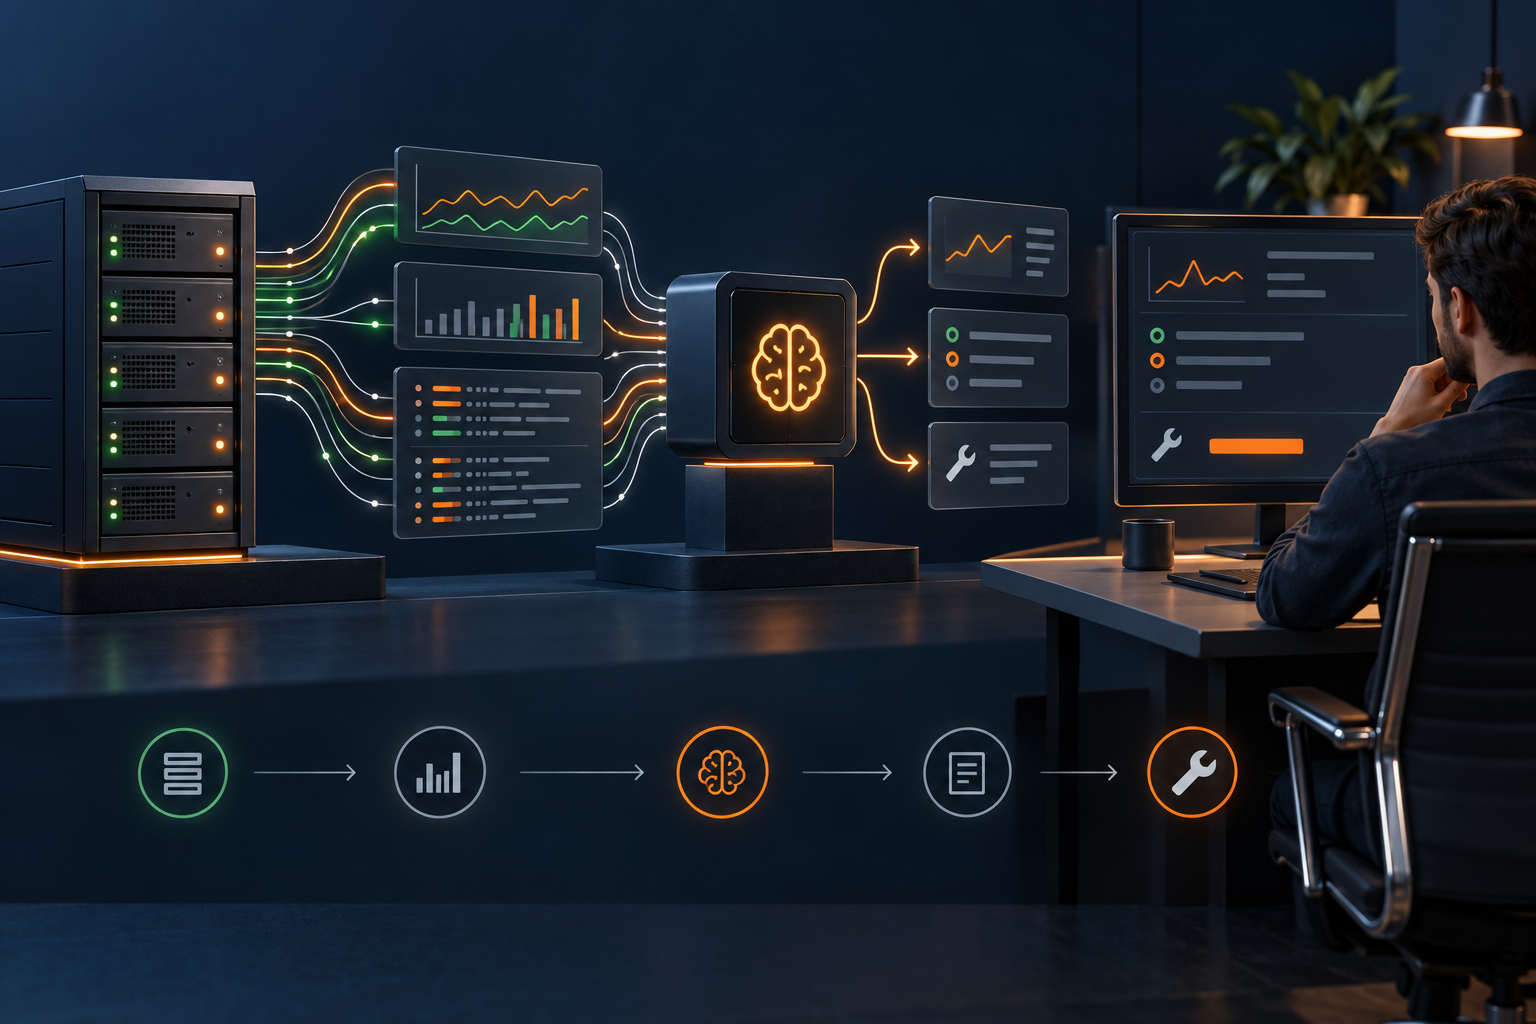
监控系统收集信号;AI 帮助解读信号;人工批准下一步操作。
收集简要的运行状况快照
收到警报时,应收集一组范围有限的只读信息,而不是让 AI 工具不受限制地访问整台服务器:
date --iso-8601=seconds
uptime
free -h
df -hT -x tmpfs -x devtmpfs
systemctl --failed --no-pager
ss -s
journalctl -p warning..alert \
  --since '-60 minutes' --no-pager
将输出发送给外部 AI 服务之前,请先进行审查。移除凭据、授权标头、会话标识符、客户数据以及与事件无关的任何内容。自动脱敏很有用,但可能会遗漏机密信息。
分析日志而不被海量内容淹没
良好的调查应从受影响的服务和事件时间窗口入手。例如,对于 Nginx:
systemctl status nginx --no-pager
journalctl -u nginx --since '-30 minutes' --no-pager
journalctl -p err..alert --since '-2 hours' --no-pager
然后补充上下文:操作系统、确切症状、症状开始时间、最近一次已知更改以及所附证据。要求助手将事实与假设分开,并在建议重启之前索取更多证据。
System: Ubuntu 24.04
Service: Nginx reverse proxy
Application: managed by systemd
Symptom: HTTP 502 responses since 14:20 UTC
Last change: application deployed at 14:05 UTC

Build a timestamped incident sequence.
Rank likely causes and cite the evidence for each.
Identify missing evidence and read-only next steps.
For later changes, include impact, rollback and verification.
审查 AI 提议的每项变更
对于提议在生产环境中实施的每项变更,都应要求提供确切的命令或差异、预期结果、可能的副作用、回滚方法和验证测试。存储在 Git 中的配置可在应用前进行检查:
git status --short
git diff --check
git diff
可以使用 ansible-playbook --check --diff 检查 Ansible playbook,但检查模式无法完全预测每个模块或应用程序的副作用。高风险变更仍应在与生产环境相似的预发布 VPS 上进行。
在 Windows VPS 上采用相同模式
AI 辅助管理并不局限于 Linux。PowerShell 可以为 Windows VPS 生成有针对性的快照,管理员可在分享前进行审查:
Get-ComputerInfo |
  Select-Object WindowsProductName, WindowsVersion,
    OsLastBootUpTime

Get-Volume |
  Select-Object DriveLetter, FileSystemLabel,
    SizeRemaining, Size

Get-Service |
  Where-Object Status -eq 'Stopped'

$since = (Get-Date).AddHours(-1)
Get-WinEvent -FilterHashtable @{
  LogName='System'
  Level=1,2,3
  StartTime=$since
} |
  Select-Object -First 100 TimeCreated, Id,
    ProviderName, LevelDisplayName, Message
使用专用 Windows 账户,并仅授予诊断任务所需的权限。不要向 AI 代理提供域管理员凭据、不受限制的生产环境机密信息,或自动重启关键业务服务器的权限。
将恢复纳入方案
AI 生成的变更可能看似合理,但仍可能不适合您的应用程序。在允许直接访问之前,请将备份保存在 VPS 之外,测试实际恢复流程,记录当前的防火墙和网络配置,并记录通过管理门户或 VNC 控制台进行紧急访问的方法。
EDIS Global VPS 客户仍需对自己的数据和恢复负责。在将 AI 代理引入重要工作负载之前,请查看当前的备份指南。
实用的运维流程
- 让监控系统检测问题并记录时间戳。
- 仅收集受影响服务的状态、指标和相关时间窗口内的日志。
- 移除机密信息和无关的客户数据。
- 要求 AI 区分事实、假设和缺失的证据。
- 先运行只读诊断命令。
- 要求提供拟议的差异、影响评估、回滚和验证方法。
- 由承担责任的管理员批准并应用变更。
- 从 VPS 外部验证服务,并更新运行手册。
AI 不会让 VPS 自动成为托管服务
AI 可以缩短故障排查时间,并提高小型团队的效率,但它不会承担运维责任。使用非托管 VPS时,您仍需管理操作系统、应用程序、访问权限、更新、监控、数据和恢复。
最佳效果来自本身已具备良好可管理性的服务器:安全访问、有效监控、受版本控制的配置以及经过测试的备份。先从只读辅助开始,仅在有明确需求时扩大权限,并保留由人工审批生产环境变更的步骤。
AI 辅助 VPS 管理:常见问题
AI 可以检查选定的服务器数据、解释命令、分析日志、准备配置变更并记录恢复步骤。它应当辅助承担责任的管理员,而不是成为生产 VPS 的唯一操作者。
默认情况下不应如此。应从选定的信息或专用的非特权账户开始。如果确实需要直接访问,请使用单独的 SSH 密钥、最小权限、审计日志,并要求特权变更经过人工审批。避免授予不受限制的免密码 sudo 访问权限。
更安全的模式是在管理员工作站上运行终端 AI 工具,并通过 SSH 使用专用受限账户连接到 VPS。代理可以收集只读证据并准备变更;另一个管理员账户负责审查并执行需要特权的操作。
AI 可以解读警报,并将指标与日志关联起来,但应由传统监控系统收集数据和检测中断。使用外部可用性检查以及 Netdata、Prometheus 或 Grafana 等工具,然后使用 AI 协助诊断相关证据。
只有在限制并审查数据后才安全。导出最短的相关时间窗口,移除凭据、令牌、客户数据和无关条目,并在上传运维信息前检查 AI 提供商的数据处理政策。
不能。AI 可以协助管理,但 VPS 所有者仍需对操作系统、应用程序、访问权限、更新、监控、备份和恢复负责。